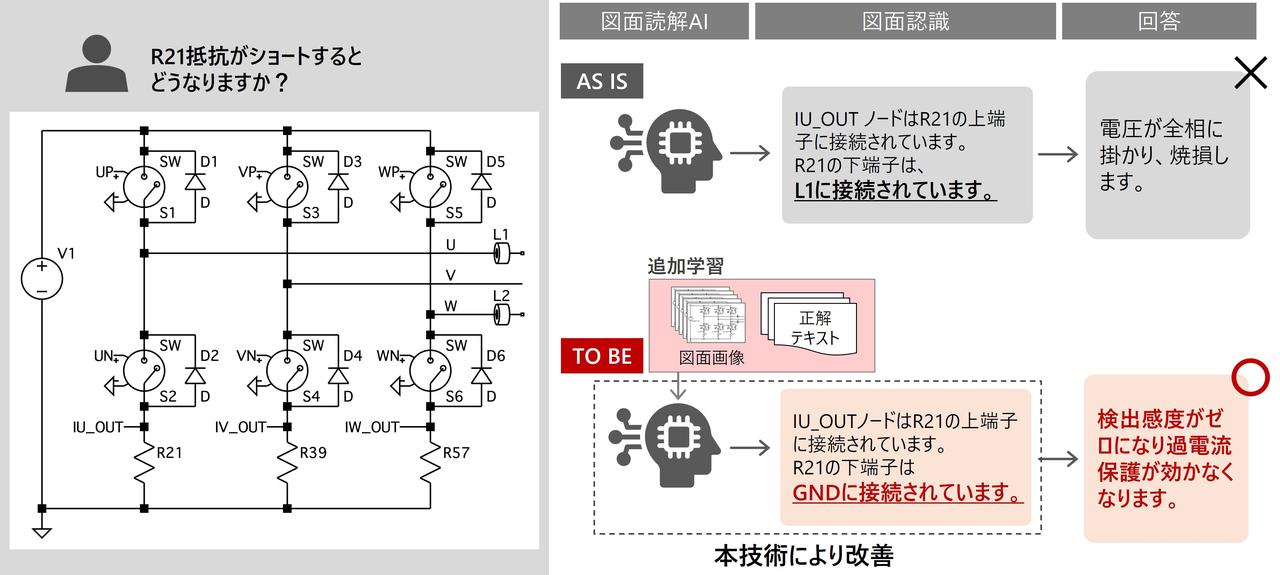
画像も扱える生成AIは、電子回路図や配線図などの技術図面も容易に理解できるはずと期待されていました。しかし実際には、部品の名称や図面の概要は説明できても、どの部品とどの部品がつながっているのか、という接続関係を正確に読み取るのは苦手という弱点がありました。日立製作所 研究開発グループは、回路図の構造をMermaid形式のテキストとして表現し、AIに学習させることで接続関係の認識精度を高める技術を開発しました。さらに複数のAIエージェントを組み合わせることで、より複雑な図面を読み解く研究も急ピッチで進めています。図面を正確なデジタルナレッジへ変換することで、設計・保守業務の効率化やノウハウ継承、さらにはフィジカルAI活用につなげる研究に取り組むDigital Innovation R&D ビジョンインテリジェンス研究部のグエン・コング・カー研究員と阿部田将史研究員に、その歩みと将来像を尋ねました。
技術を社会に役立てることをめざす
カー:私はベトナムとオーストラリアで暮らした後に来日し、大学院の博士課程に進みました。学生時代の研究は「歴史文書を対象とした手書き文字の認識」です。平城京跡から出土した木簡やくずし字、ベトナムの漢喃文字(チュノム)などを、AIを適用して読みやすくするのです。外国人として来日した当初、(日本語の)漢字や手書き文字を読むことにとても苦労したので、その経験から「AIで読めない文字を読めるようにできないか」と考えたのです。学生時代には、コンテスト優勝やワークショップにおける最優秀論文賞の受賞などを通じて、研究を評価していただきました。
日立製作所 研究開発グループ Digital Innovation R&D 先端AIイノベーションセンタ
ビジョンインテリジェンス研究部 研究員・ グエン・コング・カー
そしてその研究成果を社会ですぐに役立つ技術へと発展させたいとの思いから就職先を検討しました。その中でも日立は、AIそのものの開発に注力するだけでなく、社会インフラをはじめ、製造や医療など幅広い分野へのAI活用拡大をめざしていて、基礎研究と実用化の両方に取り組めることに魅力を感じました。日立は文字認識・画像認識など、パターン認識技術でも世界的に高い水準と実績を誇っていたんです。なので内定をいただいたときは、本当にうれしかったですね。また私の通っていた東京農工大学とここ、国分寺サイトが実は距離が近いので、慣れ親しんだ環境で研究を続けられるという安心感も日立への就職を後押ししたのかもしれません。
入社後は画像認識を中心に研究を進めてきました。文字列認識・文書分析、大規模視覚言語モデル(Large Vision Language Model)、半導体量産での寸法計測技術、細菌薬剤効果推定手法などの研究実績があります。これらに共通しているのは「画像から価値のある情報を抽出するAIを作ること」です。学生時代の研究は読めない文字を読めるようにするAIでしたが、日立入社後は画像から情報を読み解くAIにシフトした、というわけです。
阿部田:私の学生時代は、素粒子物理学で超弦理論(物質の最小単位を点ではなく1次元の「ひも」と考え、宇宙のすべての現象を説明しようとする理論)の研究に没頭していました。今の仕事とは全く関係ありません。修士課程まで進み研究を続けて、研究室の中でも人一倍勉強していたつもりですが、博士課程に進んでさらにその先でポストを得るには並々ならぬ努力と強い覚悟が必要だと感じました。自分自身の適性を考えた結果、就職することにしました。
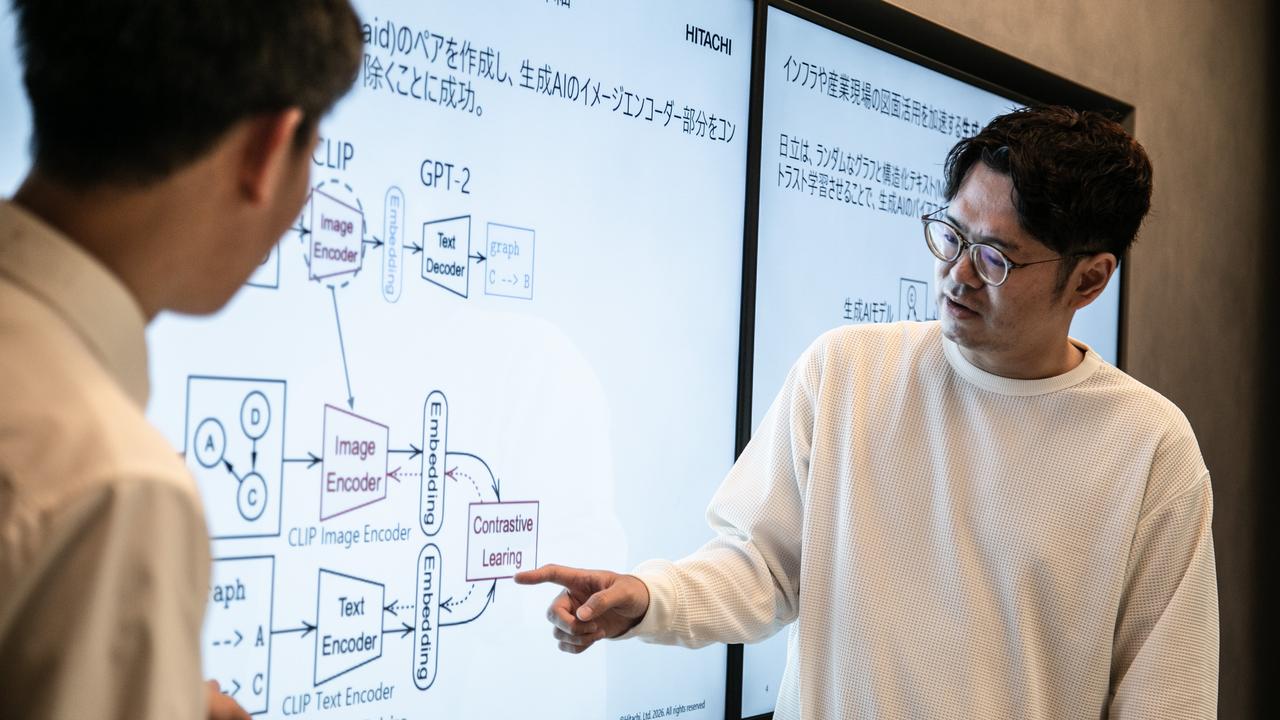
日立製作所 研究開発グループ Digital Innovation R&D 先端AIイノベーションセンタ ビジョンインテリジェンス研究部 研究員・阿部田 将史(Masafumi ABETA)
たまたま日立が主催する展示会に足を運ぶ機会があり、そこでさまざまな技術研究を紹介していただいたのですが、なかなか事業化できない技術がたくさんあること、そしてニーズとシーズを結びつけることの難しさを感じたんですね。逆にいえば、そのように「結びつける仕事」こそ求められているのではないかと考え、日立の門を叩いたわけです。
そのような経緯での入社なので、研究職ではなく事業部門のシステムエンジニアとして、まずは研究や技術の実用化に向けた検証(PoC)を担当しました。国家プロジェクトの研究などで、研究所とやり取りをして必要な実証を手掛ける役割です。車載向けコンピューターでも処理しやすい日立独自の暗号について、実証やデモを事業部門側の担当として実施したことなどを手始めに、入社から3年はいろいろなことに関わりました。「(阿部田は)順応が早いからいろいろなプロジェクトで役にたつ」と部長に言われました(笑)
代表的なプロジェクトの一つが、製薬会社向けの薬価を決めるアルゴリズムの開発でした。薬価が妥当だというエビデンスを出すためのアルゴリズムを研究所が開発し、私は事業化する際の運用方法の検討を担当しました。その後は事業部門のデータサイエンティストとして、鉄道のダイヤ分析などを手掛けた後、研究開発グループに異動しました。
そもそもニーズとシーズを結びつけて、さまざま技術を事業化につなげることを目標にして日立に入社したわけですが、事業部門での経験を活かして研究開発グループで働くことで、その目標をより実現しやすいと考えたためです。より一層技術に近い仕事に携わりたい、という想いもあったのかもしれません。
Mermaid言語で作ったグラフ表現を組み合わせたデータセットで追加学習
カー:2024年ごろからAIによる図面認識の研究に取り組んでいます。最近のAIは複雑な図面でもある程度の認識ができるようになってきましたが、2024年当時の生成AIは図面の認識があまり得意ではありませんでした。一方、日立には複雑な回路図を含む膨大な技術文書が数多くあります。これらを理解するには、専門知識がある人が多くの時間を費やす必要があります。ただし、AIの一種である視覚言語モデル(VLM: Vision Language Model)が急速に発展してきていたので、この技術を活用すれば技術文書の理解を効率化できると考えて研究を始めました。社内環境で運用できれば、機密性の高い図面をわざわざ外部に送信せずに済む点も、大きな利点だと考えました。
その後、画像も扱えるマルチモーダルLLM(Multimodal Large Language Model)が登場し、図面も理解できるのではないかと期待されるようになりました。私たちも最初はそう考えていましたが、実際に電子回路図や配線図を入力すると、正しく答えられないケースがあまりにも多い。特に難しいのは、図面内の記号コンポーネント(ノード)を正確に認識し、さらにそれらがどのようにつながっているかという関係(エッジ)を把握することです。
「AとBは接続されているか」といった比較的単純な質問でさえ、マルチモーダルLLMは正しく答えられないことが多々ありました。当然ですが、部品が増え図面が複雑になればなるほどその傾向はさらに強くなります。
最初は、図面というデータそのものの認識が難しいのだと考えました。しかし、検証を重ねるうちに別の原因が見えてきました。当たり前のことですが、生成AIは大量に学習した画像から得た知識を使って回答してしまう癖がある、ということです。図面の配線を正しく認識するのではなく、学習データから得た経験則に頼って回答してしまうのです。「フローチャートは上から下に流れることが多い」、「ネットワーク図でHUBとあれば配線が集中しているに決まっている」といった具合です。
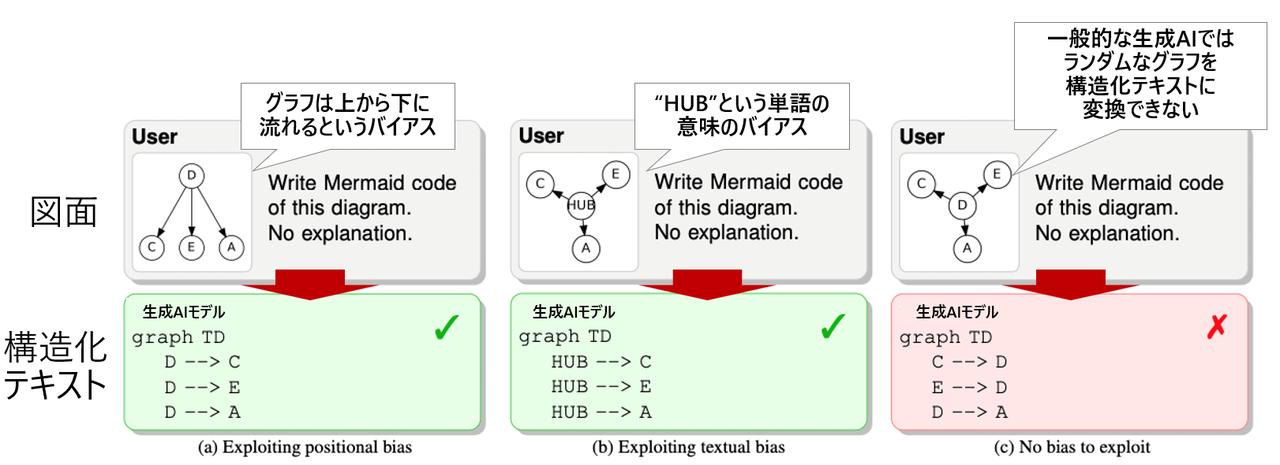
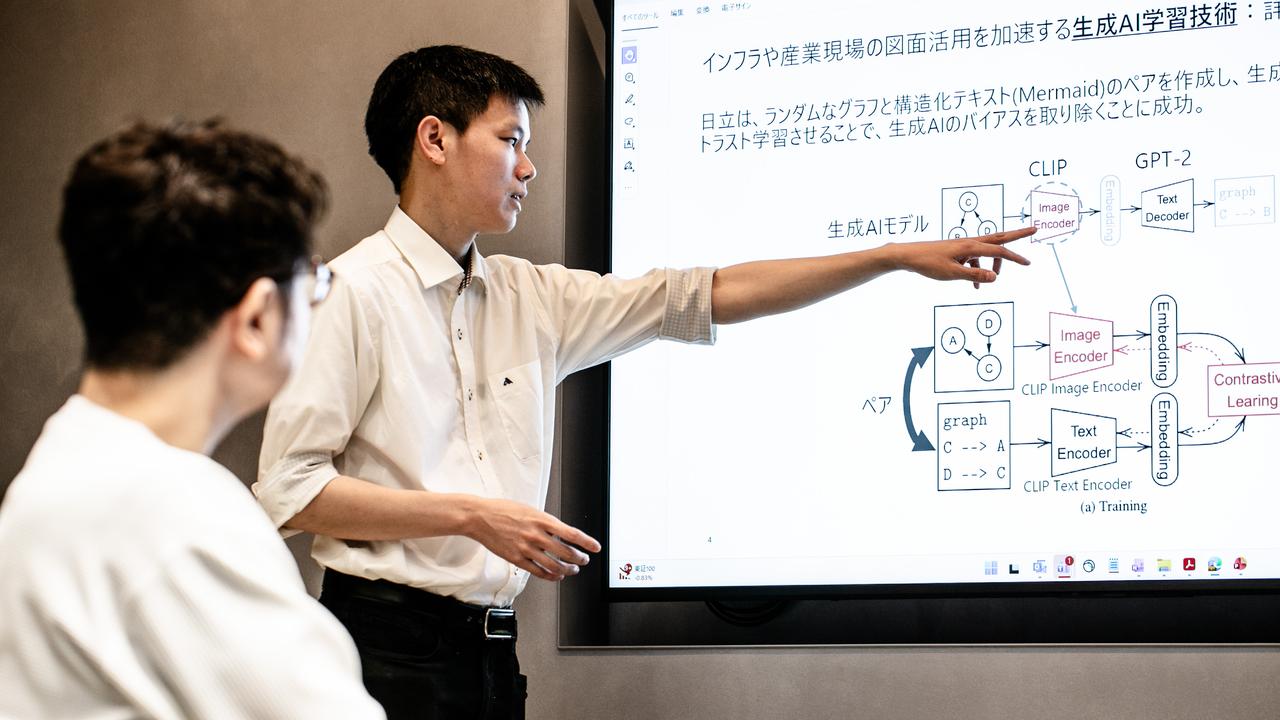
今回の研究では、こうした課題を解決するために、ビジュアルエンコーダーと大規模言語モデル(LLM)を統合した、大規模視覚言語モデル(LVLM)を開発しました。これは、画像とテキストの両方を扱えるAIモデルです。このLVLMは、回路図の画像と、その接続関係をMermaid(図の構造や接続関係をテキストで表現できる記法)で記述したデータを組み合わせたデータセットを用いて追加学習を行いました。たとえば「AとBが接続されている」といった回路の構造をMermaid記法のテキストとして表現し、回路図の画像と対応付けて学習させます。これにより、入力された回路図の特徴をイメージエンコーダーで抽出し、その接続関係を構造化されたテキストとして出力できるようにしました。実際に、回路図と、それに対応するMermaid形式の構造データを約8万組用意して学習したところ、接続関係の認識精度は、従来手法の約20%から約80%まで向上しました。
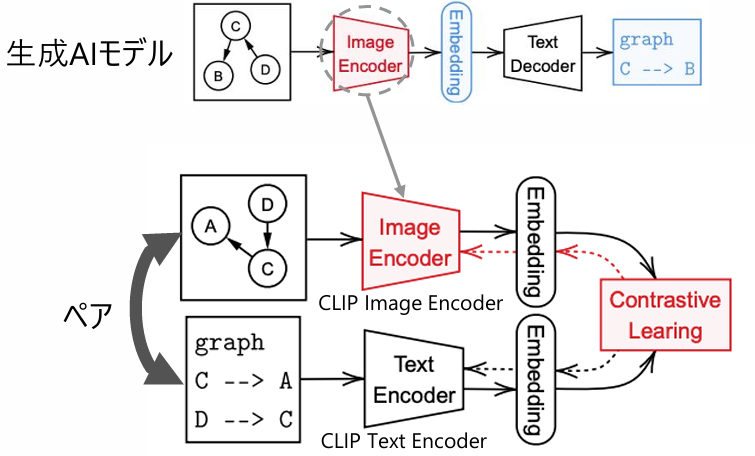
図面と構造化テキスト(Mermaid)のペアを対応付けて学習させることで、画像認識の偏りを抑制
回路図を高い精度で認識できるAIモデルの研究は、コンピュータビジョン分野の国際会議であるCVPR 2025のワークショップで採択されました。加えて、本研究で開発したAIモデルは比較的小規模な構成で実現しているため、ハイパースケーラーのサービスに頼ることなく、ローカルのデータセンターでも十分に運用できます。実際の現場で活用できる技術をめざしている点も、この研究の大きな特徴です。
より複雑な図面を理解し、接続の見逃しを激減させ、AIの活用シーンを広げる
カー:この研究は、図面を読み取れるAIモデルを作る最初のステップをクリアした段階です。最終的な目的は、複雑な図面を理解できるAIモデルを作ることです。今、そのための研究を加速させています。
阿部田:現在地として、一定の複雑さのある図面を読み取れるAIモデルが、カーさんの研究の成果などから出来上がってきました。しかし、実際の業務で本当に求められているのは、工場や生産設備全体を表すプラント図面のような、膨大な要素や書き込みを含む大規模で複雑な図面を読み取れるAIモデルです。
そのためには、複数のAIモデルを組み合わせる必要があると考えています。カーさんの研究成果で、要素と要素を注目させるエージェントが出来上がりましたが、それだけだと要素と要素を結ぶ線が長くなったときに正しく認識できないこともあり得ます。そうした場合には線を目立たせたり、線に色を付けたりするように、検出の部分を組み合わせていく工夫が必要になります。
カーさんの研究成果を近くで見ていて、当時としては非常に大きな前進だと感じていました。この技術を応用すれば、さらに高い精度で複雑な図面を読み取れると考えたのです。カーさんの研究では、図面全体を入力して構造を一度に読み取ることはできますが、より複雑な図面になるほど、図面の細かな接続関係を見落としやすくなります。そこで私は、1枚の図面を複数の観点に分け、それぞれを詳細に分析するAIエージェントを開発しました。全体を把握するAIと、特定の部品や接続関係を重点的に調べるAIを組み合わせることで、図面の読み取り精度をさらに高めています。
例えば「AとCのつながりを見るエージェント」「DとCのつながりを見るエージェント」といった具合で、分担して画像を分析することで、精度が高い出力を得られるように改良していきました。その上で、それぞれのエージェントの出力の間に矛盾があったら、さらに詳細に分析するエージェントも組み合わせました。こうした複数のエージェントを実装していくことで、AIモデルがより高い精度で図面を理解することができるようになったんです。その1つの成果が、接続の見逃しを大幅に減らせるようになったことです。まだハルシネーションとして余分な線の出力を出してしまうことはありますが、見落としがなくなることで実用へのステップを着実に歩んでいると思いますね。
一般にLLMは、テキストの分析や質問への回答を得意としています。一方、図面のように特殊な画像を読み取り、その構造を理解することは必ずしも得意ではありません。図面を理解するAIモデルが使えるようになると、図面を読み取らないとわからないことをLLMにテキストで渡して、図面についてLLMが回答できるようになります。これでAIの活用シーンがぐんと広がると考えています。
図面と技術文書をナレッジにして社会課題の解決へ
カー:今後は、この研究で培った図面理解技術を基盤に、図面の解析や知識活用まで含めた次のステップの研究につなげていきたいです。たとえば、図面のデータからMermaid形式のテキストデータに変換することで、図の構造をテキストとして扱えるようになり、図面の理解や分析がしやすくなります。あわせて、図面のデータの保存や送信をテキストベースで行えるようになるため、データの軽量化にもつながると考えています。
阿部田:この研究がさらに進むことで、図面から読み取った情報と、設計書から読み取った情報、手順書、点検履歴などのナレッジのデータベースを組み合わせることが可能になります。たとえば図面から機器同士の接続関係を理解できれば、ある要素が故障したときに、接続先の別の要素にどのような影響が及び、どのように対処すべきかといったことが理解できるようになるでしょう。図面を理解するAIモデルが実用化されれば、現場の業務にこれまでなかった知恵を提供できるようになると考えています。
カー:私たちがめざしているのは、企業ごとの製品や設計ルールに合わせてカスタマイズでき、技術者が安心して利用できる実用的なAIです。社内環境で運用できれば機密情報を外部へ送る必要がなく、用途を特定業務に絞ることで運用コストも抑えられます。設計や保守の効率化に加え、熟練者が図面から読み取ってきた知識やノウハウの継承にも貢献できるはずです。
阿部田:そして現在は、図面を理解するAIモデルとは別に、フィジカルAIにおける画像処理の研究にも取り組んでいます。フィジカルAIは、ロボットなどのデバイスが撮影した画像を認識して、現実世界に対するさまざまな働きかけを実現します。ところが、ロボットなどが撮影した画像が、照明の影響や画角などから認識に適切でないケースが散見されます。そこで私たちは、必要な情報の欠落を防ぐための画像処理技術も研究しています。人手不足が社会課題となるなかで、機器や設備、インフラなどの点検は欠かせません。点検の現場にロボットたちが入って、フロントラインワーカーの方々が効率的かつ安全に仕事ができるようにしたいとの想いです。
この研究も、先ほど紹介した図面認識AIの研究とつながっています。図面を読み取ってナレッジとして蓄積できるようになれば、ロボットが撮影した画像から現場での異常を認識できるようになるでしょう。ロボットが図面の内容を理解しながら、手順書などから対応を読み解いていければ、人間と同じような点検整備や保守などの作業が、ロボットでも対応可能になります。ロボットが参照できるナレッジを構築するうえで、図面を認識するAIモデルは非常に重要な存在です。私は、この技術がフィジカルAI時代において、技術の可能性(シーズ)と現場の課題(ニーズ)を結びつける重要な役割を果たすと考えています。
弱みを可能性に変えてくれた恩師の著書
グエン・コング・カー(Cong Kha Nguyen)
日立製作所 研究開発グループ Digital Innovation R&D
先端AIイノベーションセンタ ビジョンインテリジェンス研究部 研究員
「弱みを強みに 手書きをデジタルに」(中川正樹著、OROCO PLANNING CO.,LTD.)を紹介します。大学時代の指導教官だった、東京農工大学 中川正樹先生の著書です。手書き文字認識を中心にした書籍で、最も印象に残ったのは、「弱みを強みに変える」という考え方でした。日本に来て漢字の読み書きに苦労したことは弱みだと思っていましたが、「弱みを強みに変える」ことで読めない文字をAIで読めるようにする研究テーマに出会えました。現在の図面理解の研究にもつながっています。この経験から、本質的な課題に向き合いそれを研究テーマへと発展させる姿勢を学びましたし、現在の研究でもこの考え方を大切にしています。
リーダーシップとは何かを考え実践するための一冊
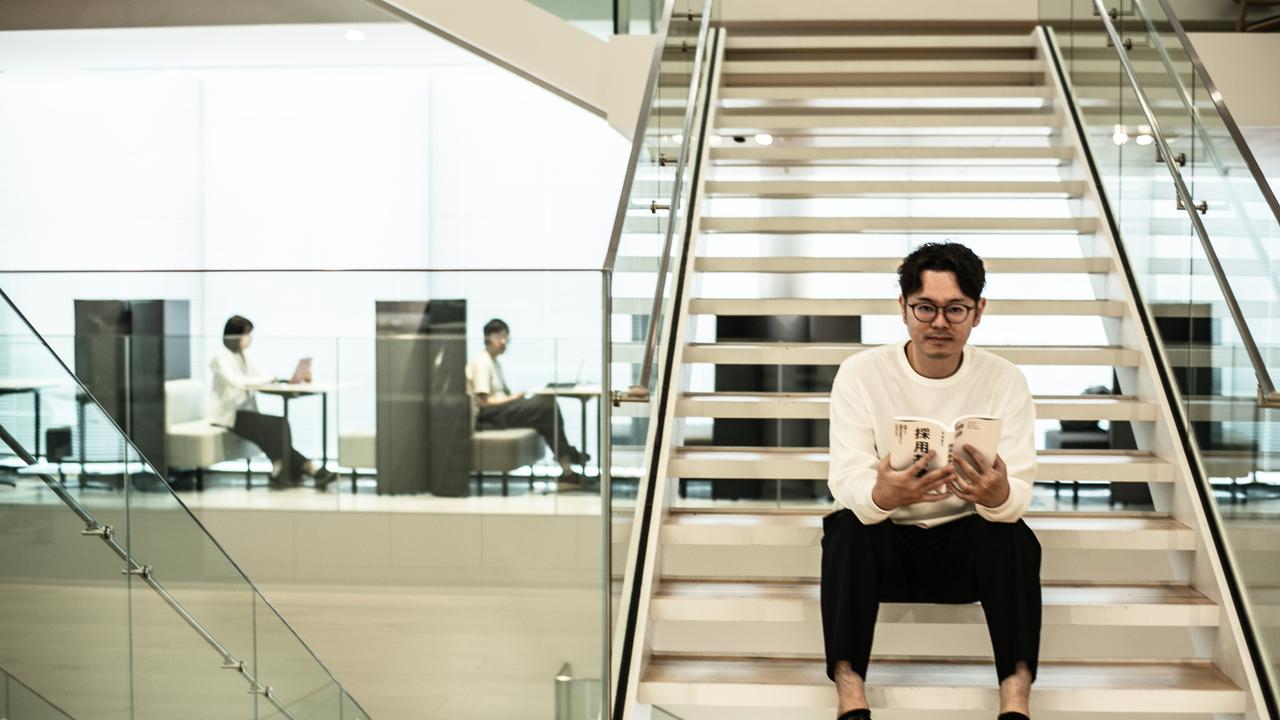
阿部田 将史(Masafumi ABETA)
日立製作所 研究開発グループ Digital Innovation R&D
先端AIイノベーションセンタ ビジョンインテリジェンス研究部 研究員
10数年前に読んで、今でも読み返している本に「採用基準」(伊賀泰代著、ダイヤモンド社)があります。マッキンゼーで人事に携わっていた著者が、採用を通じてリーダーシップとは何かについて論じています。リーダーシップとは、全社員が自分自身で発揮するものであり、その結果として自分の人生を自分でコントロールできるようになるというのです。仕事では2026年度からチームリーダーになり、自分がめざす方向をメンバーに伝えてチームとして動くことをこの本から学んだ考え方で実践しています。プライベートでも、場を楽しくする方向に持っていくことで、自分の人生でできることが広がっていくように感じています。
(撮影:服部 希代野)