似た候補に偏らず異なるKPIバランスを持つ複数の案を提示し、現場の用途や制約条件に応じた意思決定を支援
日立は、相反する複数のKPI*1を同時に考慮することが求められる社会インフラや産業分野などにおいて、現場の用途や制約条件に応じて複数の候補を生成するLLM(大規模言語モデル)*2学習技術を開発しました。例えば、モビリティの運行計画作成や物流における配送計画作成では、運行効率を高めると同時に消費電力を抑える必要があるなど、複数のKPIのバランスを考慮した意思決定が求められます。従来のLLM向け強化学習では、複数KPIを1つの総合点にまとめて最適化することが多く、総合点を最大化する特定のバランスに候補が偏りやすいことに加えて、各KPIの優先度を変更して最適化するにはAIの再学習が必要となるため、現場の状況に応じて柔軟に対応しにくいという課題がありました。本技術では、生成した候補群全体の性能と多様性を向上させるように学習することで、似た候補に偏らず異なるKPIバランスを持つ複数の案を提示し、現場の用途や制約条件に応じた意思決定を支援します。論理回路設計分野の回路生成タスク*3において、本技術の有効性を検証したところ、学習前のモデルと比較して、多様で有力な回路候補をどの程度広く得られたかを示す網羅率が最大13.3%向上することを確認しました。
今後、日立は本技術の有効性の検証を進めるとともに、モビリティ、物流、ワットビット連携*4、回路設計などへの応用を検討し、意思決定支援の高度化を通じて、安定運用と省エネルギー・生産性向上の両立に貢献していきます。
*1 KPI: Key Performance Indicatorの略。組織やプロジェクトの最終目標の達成に向けて、進捗状況を測るための中間指標。
*2 LLM: Large Language Modelの略。大量の文章データを学習し、文章の生成や要約、質問応答に加え、与えられた条件に基づく案の作成なども行えるAIモデル。
*3 回路生成タスク: 回路に求められる仕様や条件に基づいて、AIが複数の回路案を生成し、消費電力や処理速度、回路規模などの指標で評価する課題。
*4 ワットビット連携: 電力(ワット)とデータ処理・通信(ビット)を連携させ、電力の状況や通信条件に応じて計算処理の場所や時間を最適化する考え方。
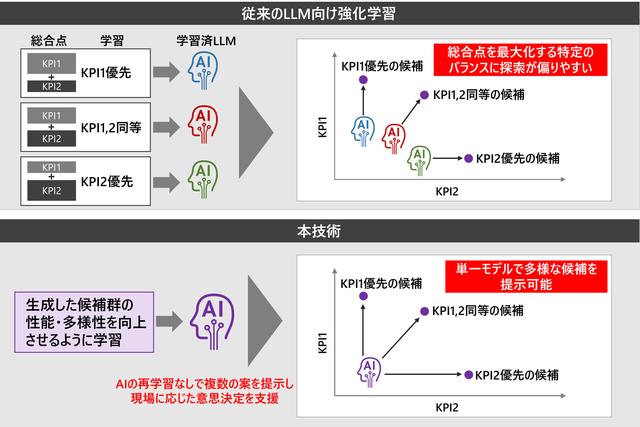
図1 従来技術の課題と開発技術の効果
背景および課題
脱炭素やエネルギー価格の変動、安定供給への要求の高まり、人手不足などを背景に、社会インフラや産業分野では、複数のKPIを同時に満たす意思決定の重要性が高まっています。例えば、モビリティ分野(鉄道・自動車の運行制御など)では、運行計画を作成する際に運行効率を高めると同時に消費電力を抑える必要があり、物流分野では配送計画を作成する際に輸送時間を短縮すると同時に電力コストを抑える必要があるなど、相反する複数のKPIを考慮する必要があります。このような中、近年ではAIを活用した最適化が進められていますが、従来のLLM向け強化学習では、複数のKPIを1つの総合点にまとめて学習することが多いため、総合点を最大化する特定のバランスに探索が偏りやすく、かつ、各KPIの優先度を変更して最適化するにはAIの再学習が必要となるため、現場の状況に応じて比較検討できる多様な候補を効率よく得ることが難しいという課題がありました。
課題を解決するために開発した技術・ソリューションの特長
そこで日立は、相反する複数のKPIが存在する問題において、候補群全体の価値を高めながら、複数の有力な候補をLLMに生成させる学習技術を開発しました。本技術により、複数の候補を比較しながら、現場の用途や制約条件に合った意思決定を行えるようになります。技術の特長は以下の通りです。
1. 生成する候補群の性能・多様性を向上させる逐次学習技術
候補群全体の性能・多様性を向上させるには、複数の候補をまとめて評価しながら学習する必要がありますが、LLMに一度に多くの候補を生成させると出力が長くなり、学習効率が低下するという課題がありました。本技術では、前回までに生成した候補を踏まえて次の候補を生成し、その候補が候補群全体の性能・多様性にどの程度貢献したかを評価しながら学習する仕組みを構築しました。これにより、単一の候補を生成・評価して学習する既存のLLM向け強化学習のアルゴリズムを活かしながら、最終的に得られる候補の性能・多様性を向上させるようにLLMを学習させることが可能になります。
2. 異なるKPIバランスを持つ候補を生み出すハイパーボリューム寄与度に基づくLLM向け強化学習
相反する複数のKPIが存在する問題では、1つの最適解だけを求めるのではなく、異なる特徴を持つ複数の候補を揃え、その中から用途や制約条件に合った候補を選択できることが重要です。本技術では、生成された候補が候補群全体の性能・多様性にどの程度貢献したかを評価するため、GRPO*5と呼ばれるLLM向け強化学習に、AIが学習する際の評価指標として用いられているハイパーボリューム寄与度*6を適用しました。これにより、似た候補の繰り返しではなく、異なるKPIバランスを持つ候補を生み出す方向に学習を進めることができます。その結果、限られた評価回数でも、現場で比較検討しやすい複数の有力候補を得やすくなり、用途や制約条件に応じた意思決定を支援します。
*5 GRPO: Group Relative Policy Optimizationの略。LLMの出力結果を評価しながら学習を進める強化学習手法の一つ。
*6 ハイパーボリューム寄与度: 複数の評価指標があるときに、ある候補が候補群全体の性能・多様性をどれだけ高めたかを表す指標。既にある候補と似た案ではなく、異なる特徴を持つ有力な候補を見つけるために用いる。
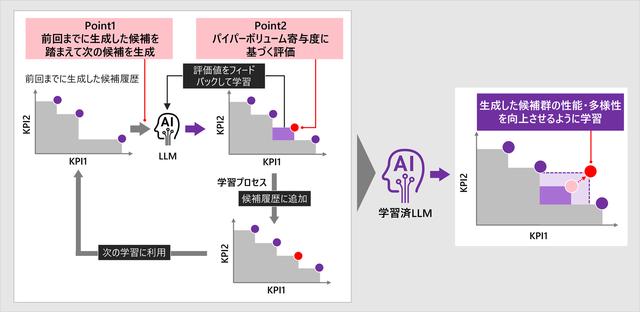
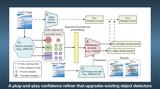
図2 複数の有力な候補をLLMに生成させる学習技術の概要
確認した効果
複数KPIを客観的かつ自動的に評価できる論理回路設計分野の回路生成タスクにおいて、多様で有力な回路候補をどの程度広く得られたかを示す網羅率を用いて本技術の有効性を実証しました。その結果、学習前のモデルと比較して網羅率が最大13.3%向上することを確認しました。これにより、回路設計者は同じ仕様に対して、「高速性を重視した回路」「省電力を重視した回路」「小型化を重視した回路」など、用途や製品要件に応じた複数の候補を比較しながら選択できることが示されました。
今後の展望
今後、日立は本技術を社会インフラ知能基盤モデルであるIntegrated World Infrastructure Model (IWIM)を支える意思決定高度化技術として位置づけ、本技術の有効性の検証を進めるとともに、モビリティ、物流、ワットビット連携、回路設計などの分野への応用を検討していきます。また、複数KPIを考慮した意思決定支援の高度化を通じて、安定運用と省エネルギー・生産性向上の両立に貢献していきます。
なお、本成果の一部は2026年10月6日から8日に米国サンフランシスコで開催されるThe Third Annual Conference on Language Modeling (COLM2026)で発表予定です。
本研究の一部は、国立大学法人東京科学大学岡崎研究室のご協力を得て実施しました。
照会先
株式会社日立製作所 研究開発グループ